角色一致性:同一角色跨镜头不换脸的三种做法
做 AI 短剧,最容易崩的不是剧情,是脸。第一集还是同一个人,到第三集就换了张脸,观众一眼出戏,后面再精致的画面也救不回来。角色一致性不是玄学,它是一套可以固定下来的流程,核心只有一句话:先把人定住,再让他动。 一、定妆照决定后面所有镜头 …
做 AI 短剧,最容易崩的不是剧情,是脸。第一集还是同一个人,到第三集就换了张脸,观众一眼出戏,后面再精致的画面也救不回来。角色一致性不是玄学,它是一套可以固定下来的流程,核心只有一句话:先把人定住,再让他动。
一、定妆照决定后面所有镜头
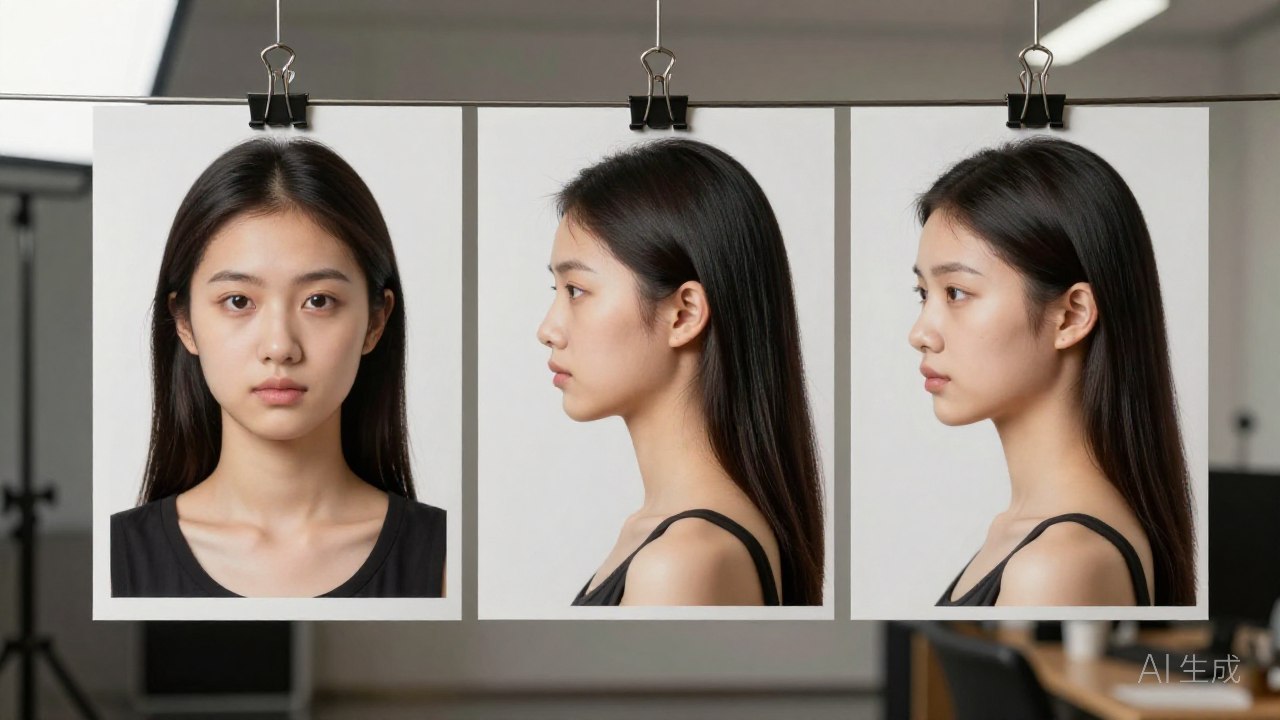
很多人一上来就按分镜逐镜生成,生成到第三个镜头才发现人物的脸已经飘了。正确顺序是先做“定妆照”:用一段固定的人物描述,生成正面、侧面、半身三张图,挑一张最满意的锁住。
这段描述要具体到能被重复:年龄段、脸型、发型与发色、瞳色、服装、标志性配饰,以及画风。写“二十七八岁的女性,短圆脸,齐肩黑发别在耳后,左耳一枚细银圈,米色针织衫,写实电影质感”,比写“漂亮的年轻女生”有用得多。
定妆照一旦满意,就不要再去改这段描述。后面所有镜头都以它为基准,包括换季换装的镜头——先换衣服,再让脸保持不动。
二、生成阶段只改动作,不改人
第二个崩点是提示词越写越自由。同一场戏里每个镜头都重新描述一遍人物,模型就会在每次描述里重新“想象”一张脸。
做法是把人物描述拆成固定前缀,把景别、动作、表情、环境放在后半段。比如前缀永远是那段定妆描述,后面只写“中景,转身推门,眉头微皱,室内暖光”。你改的只有后半段。提示词里也不要写“同一个角色”“保持人物一致”这类话,模型听不懂指代,它只认你给的具体特征。
能放参考图的工具就一定要放:上传定妆照作为参考图或角色 ID,参考强度调高,同时控制动作幅度——从“转身”直接跳到“奔跑加回头”这种大动作,人脸最容易变形。连续镜头尽量固定种子,只改动作词;确实需要换场景时,再重新给一次参考图。
还有一个容易忽略的点:同一场戏的多个镜头,最好共用一张场景图做首帧,人物站位用文字限死,模型就不会把人和背景一起重画。
三、跨场景兜底的三层手段
再规范也总会遇到漂移,尤其是侧脸、低头、手部遮挡这些角度。这时候别整张重来,按代价从低到高处理。
第一层是局部重绘:只框住脸或手重新生成,身体和构图不动。第二层是后期换脸:把定妆照的脸统一贴回各个镜头,适合已经生成完、只差脸部不一致的成片,注意只换五官、保留原镜头的表情和光影。第三层才是训练 LoRA:同一个角色要出二十个以上镜头、后面还要反复用时,才值得用十到二十张多角度的干净图去训练一个小模型。
顺序不要弄反。能重绘解决就不要换脸,能换脸解决就不要训练,训练是最后的手段,不是第一选择。
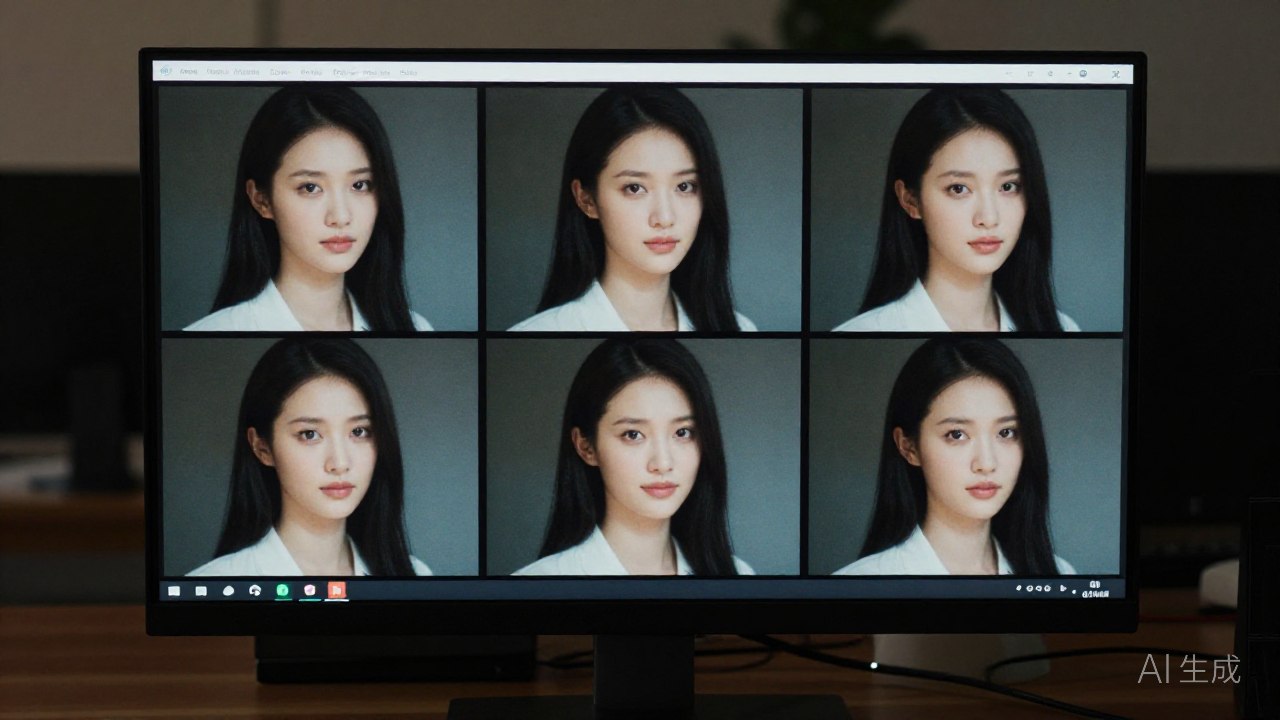
返工时建议做一张角色对照表:把定妆照和每个镜头的截图并排,按镜头号标出不通过的项,只改被标记的镜头。别凭记忆判断像不像——隔着几十个镜头看久了,人眼会自动适应,反而更容易放过问题。
四、发布前过一遍检查清单
- 脸型与下颌线是不是同一个人
- 发型分缝、发色、长度是否一致
- 瞳色与眼型有没有变化
- 服装的领口、材质、配饰是否连贯
- 手部有没有多指、扭曲
- 同一场景的光线方向是否统一
检查时先看“像不像同一个人”,再看“好不好看”。这两件事冲突时永远选前者——观众可以接受画面糙一点,但接受不了主角换脸。
一句话总结:把人物描述当成资产锁死,把参考图当成基准反复喂,把重绘和换脸当成兜底。流程固定下来,一致性就是可复现的结果,而不是运气。
本文由 AI 辅助生成,经编辑审核后发布。
暂无评论,快来发表第一条评论吧